


وقتی Query سریع بود ولی حالا نیست
یه پروژه رو فرض کن که شیش ماه پیش راه انداختیش و همون اول کار همه چی خوب بود، صفحه لیست سفارشها زیر نیم ثانیه لود میشد و هیچکس هم شکایتی نداشت کد همون کده مدل همون مدله، حتی یه خط query هم عوض نشده فقط جدول Order اون موقع سه هزار رکورد داشت و الان دویست هزارتا شده و همین یه چیز خیلی چیزها رو عوض میکنه
جالبه که هیچکس اول شک نمیکنه به دیتابیس همه فکر میکنن سرور ضعیفه یا جنگو خودش کنده یه بار یکی از تیمها اومد گفت باید RAM سرور رو دو برابر کنیم چون صفحه گزارشگیری داره timeout میده کسی هم نگفته بود بریم ببینیم دقیقاً چه query ای این وسط اجرا میشه
اگر مثل همیشه توی مقاله های دیگه م اولین راه حلت برای کند شدن پروژه خرید سرور قویتره این متن احتمالاً چند میلیون تومن برات صرفهجویی میکنه. چون مسئله معمولاً نه CPU هست نه RAM یه فیلد سادست که تو فیلتر یا order_by استفاده میشه ولی هیچ Index ی روش نیست و Postgres مجبوره برای هر query کل جدول رو یک به یک بگرده
این نوع کندی یه ویژگی داره که باید بشناسیش: تدریجیه. یه روزه نیست ، هر هزار رکورد جدید یهکم روش اثر میگذاره تا یه جایی که کاربر شکایت میکنه و تازه میری دنبال دلیلش...اونجا هم معمولاً چند هفته مانیتور نکردن و حدس زدن طول میکشه در حالی که جوابش تو یه خط migration بود
یه بار روی فیلتر ساده یه صفحه گیر کردیم
یه پروژه فروشگاهی داشتیم که صفحه لیست سفارشهای یه فروشنده خاص بعد از چند ماه کار کردن بیدردسر یهو شروع کرد به کند شدن فیلتر خیلی ساده بود؛ فقط Order.objects.filter(seller_id=x) که توی هر پنل فروشنده صد بار در روز اجرا میشد اولش فکر کردیم مشکل از سمت فرانتاند یا کش هست، چون منطق کد از اول همین بود و دستکاری نشده بود
رفتیم سراغ Debug Toolbar و دیدیم که همین یه Query تنها خودش چند صد میلیثانیه طول میکشه بقیه صفحه سریع بود فقط همین یکی گیر داشت. با EXPLAIN ANALYZE روی همون Query نگاه کردیم و اونجا Postgres با کمال آرامش نوشته بود Seq Scan روی جدول Order یعنی داشت رکورد به رکورد کل جدول رو میگشت تا seller_id مطابق پیدا کنه
جالب اینجا بود که جدول اولش کوچیک بود و همین Seq Scan هم سریع اجرا میشد، برای همین کسی متوجه نشده بود مشکلی هست اما با رشد دادهها تعداد سفارشها از چند هزار به چند صد هزار رسیده بود و همون الگوی قدیمی دیگه جواب نمیداد و فیلد seller_id از اول هیچ Index نداشت چون کسی موقع طراحی مدل به این فکر نکرده بود که این فیلد قراره پایه اصلی فیلتر کردن باشه
آخرش فقط یه db_index=True روی فیلد گذاشتیم و مایگریشن زدیم و همون Query که قبلاً چند صد میلیثانیه طول میکشید رفت زیر چند میلیثانیه هیچ سروری عوض نشد هیچ کدی بازنویسی نشد فقط Postgres یاد گرفت مسیر کوتاهتری برای پیدا کردن رکوردها انتخاب کنه
Index دقیقاً چیه و چرا Postgres خودش نمیزنه
خیلیا فکر میکنن Index و دیتابیس خودش موقع نیاز میسازه ولی اینطور نیست Index یه ساختار داده جداست که Postgres کنار جدول اصلی نگه میداره تا بهجای خوندن ردیفبهردیف کل جدول، مستقیم بره سراغ جایی که داده مورد نظرت هست فرض کن یه دفترچه تلفن هزار صفحهای داری بدون فهرست باید هر صفحه رو ورق بزنی تا اسم مورد نظر رو پیدا کنی ولی با فهرست میدونی دقیقاً کجا نگاه کنی
این دقیقاً فرق Seq Scan و Index Scan هست Seq Scan یعنی Postgres کل جدول رو ردیف به ردیف میخونه تا شرط فیلترت رو چک کنه حتی اگه فقط ده تا از یه میلیون ردیف رو نیاز داشته باشی ولی Index Scan یعنی از یه ساختار درختی (معمولاً B-Tree) استفاده میکنه که مستقیم میره سراغ ردیفهای مرتبط، بدون اینکه بقیه رو حتی نگاه کنه که روی جدول کوچیک فرقش حس نمیشه، ولی روی جدولی که صد هزار ردیف بالاتر رفته، فاصلهش از چند میلیثانیه تا چند ثانیه میرسه
نکتهای که خیلیا نمیدونن اینه که Postgres بهصورت خودکار فقط برای Primary Key و فیلدهای Unique ایندکس میسازه، نه برای هر فیلدی که توی WHERE یا filter استفاده میکنی یعنی اگه مدلت یه فیلد status یا user_id داره که مدام روش فیلتر میزنی، Postgres به خودش زحمت نمیده Index بسازه، چون از نیت تو خبر نداره و فقط قوانین سازگاری داده (مثل یکتا بودن id) رو رعایت میکنه تصمیم اینکه کدوم فیلد به Index نیاز داره، کاملاً روی دوش خودت هست، و اگه این تصمیم رو نگیری، هر Query روی اون فیلد به همون سرعت روز اول باقی میمونه، حتی وقتی جدول ده برابر بزرگتر شده
از کجا بفهمیم یه فیلد به Index نیاز داره
قبل از اینکه Index بزنی، باید مطمئن شی که واقعاً مشکل از همینجاست، نه از یه Query N+1 یا یه Serializer که داره بیخودی همه فیلدها رو لود میکنه و راه قطعی برای این کار حدس زدن نیست، اجرا کردن EXPLAIN ANALYZE روی همون کوئری واقعیه که جنگو تولید میکنه
اول باید Query خام رو ببینی تو شل جنگو راحت میتونی SQL نهایی رو دربیاری:
from myapp.models import Order

qs = Order.objects.filter(status="pending", created_at__gte="2024-01-01")
print(qs.query)
خروجیش یه SQL خام میده. همون رو کپی کن و تو psql با EXPLAIN ANALYZE اجرا کن:
EXPLAIN ANALYZE
SELECT * FROM orders_order
WHERE status = 'pending' AND created_at >= '2024-01-01';
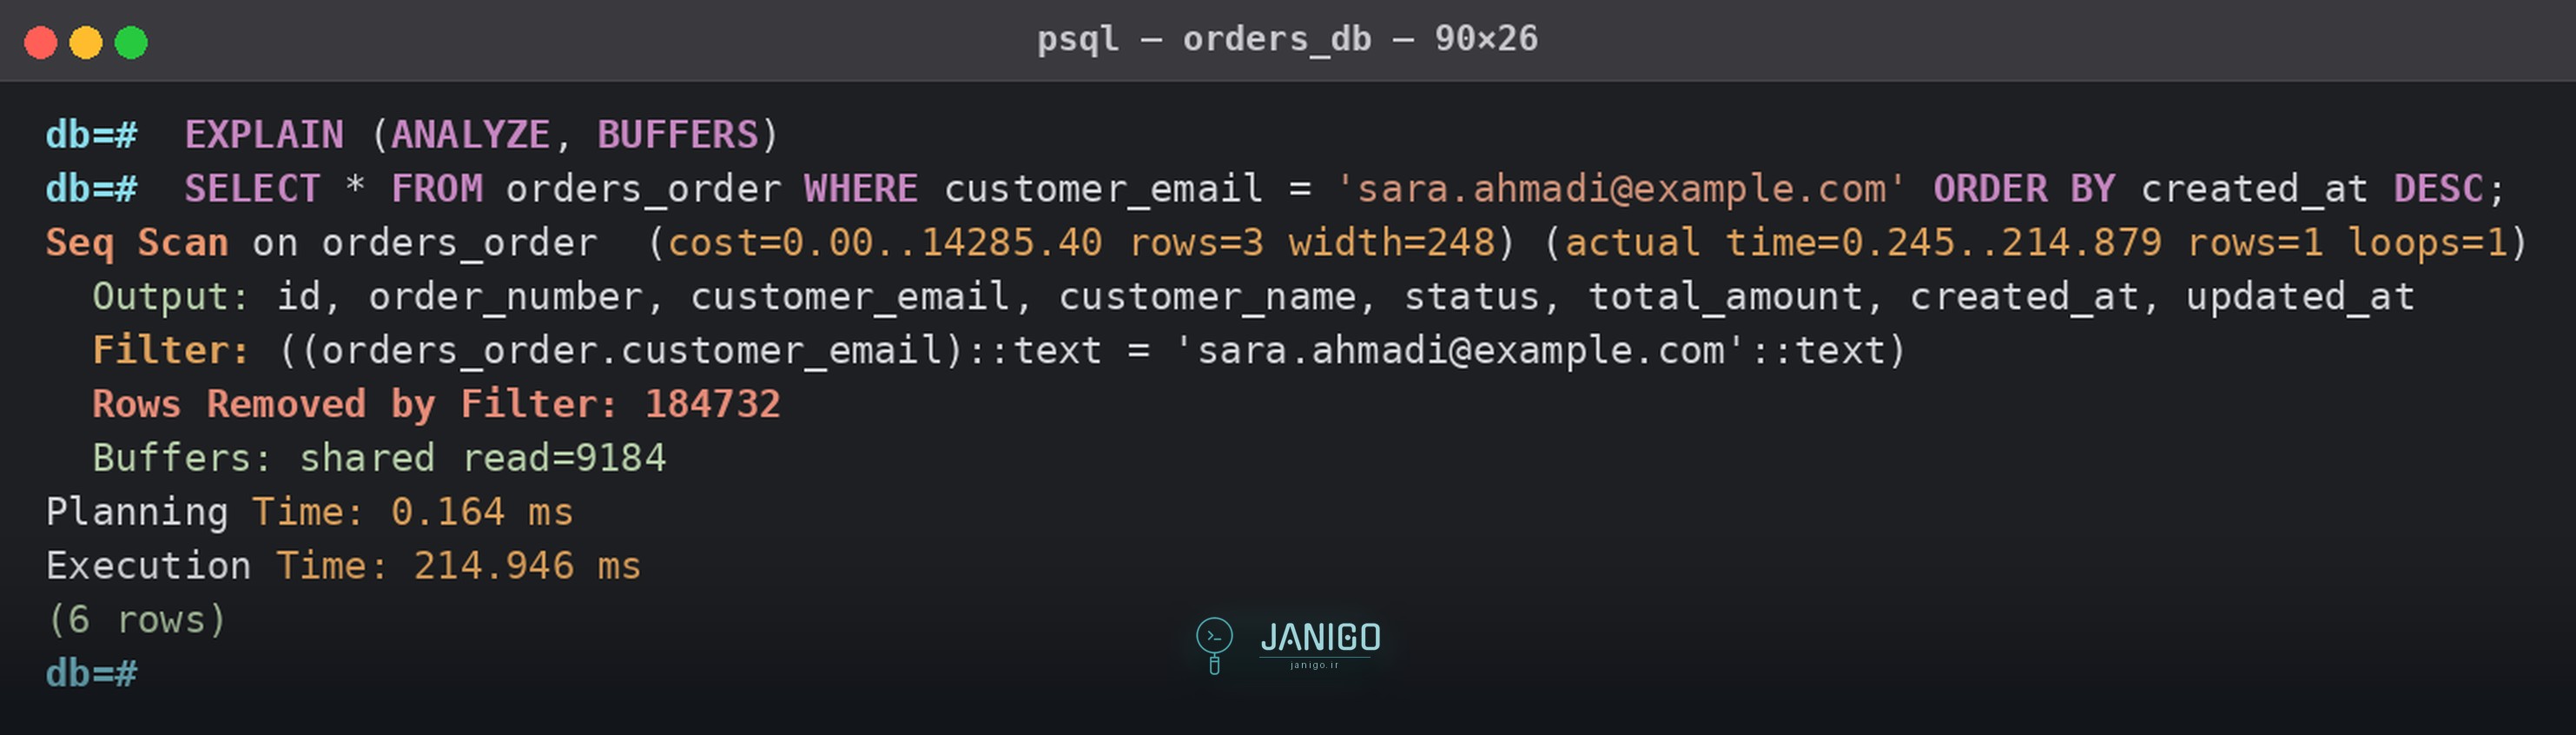
چیزی که باید دنبالش باشی خط Seq Scan توی خروجیه اگه دیدی روی یه جدول چند صد هزار ردیفی نوشته Seq Scan on orders_order و rows=350000، یعنی Postgres کل جدول رو خط به خط چک کرده تا این چند تا ردیف مطابق شرط رو پیدا کنه و این دقیقاً همون جاییه که Index میتونه قصه رو از Seq Scan به Index Scan تغییر بده و زمان اجرا رو از چند صد میلیثانیه به چند میلیثانیه برسونه
نکته مهم: به عدد cost هم نگاه کن، ولی چیزی که واقعاً به کارت میاد actual time هست، چون cost فقط تخمین برنامهریزه، نه واقعیت اجرا
راه دوم، سریعتر و برای روزمره مناسبتره: django-debug-toolbar اگه هنوز نصبش نکردی:
pip install django-debug-toolbar
و توی settings:
INSTALLED_APPS += ["debug_toolbar"]
MIDDLEWARE += ["debug_toolbar.middleware.DebugToolbarMiddleware"]
INTERNAL_IPS = ["127.0.0.1"]
بعدش وقتی صفحه رو باز میکنی، تو پنل SQL همه Queryهای اون Request رو با زمان اجراشون میبینی اگه یه Query داشت که چند ده میلیثانیه طول کشیده و روی یه فیلد فیلتر شده که Index نداره، دقیقاً همونه که باید بررسیش کنی جالبه که خیلی وقتا مشکل از یه فیلد ساده مثل status یا user_id هست که تو مدل معمولی تعریف شده ولی هیچوقت db_index=True یا Meta.indexes نگرفته
فرض کن این پنل رو باز کردی و دیدی یه Query دقیقاً همون فیلتریه که تو کد بالا نوشتیم؛ همون لحظهست که وقتش رسیده بری سراغ اضافه کردن Index نه قبلش
اضافه کردن Index روی یه فیلد در مدل جنگو
خب حالا که فهمیدیم کدوم فیلد مشکل داره، وقتشه دست به کد بشیم سادهترین راه اینه که مستقیم روی خود فیلد db_index=True بذاری، جنگو خودش موقع Migration یه Index براش میسازه فرض کن یه مدل سفارش داری که همیشه بر اساس وضعیتش فیلتر میکنی:
class Order(models.Model):
    STATUS_CHOICES = [
        ("pending", "در انتظار"),
        ("paid", "پرداخت شده"),
        ("shipped", "ارسال شده"),
    ]
    status = models.CharField(
        max_length=20,
        choices=STATUS_CHOICES,
        db_index=True,
    )
    created_at = models.DateTimeField(auto_now_add=True)
    customer = models.ForeignKey(
        "Customer",
        on_delete=models.CASCADE,
    )
بعد از این کافیه makemigrations بزنی و جنگو خودش یه فایل Migration میسازه که توش یه AddIndex هست. چیزی شبیه این:
# migrations/0004_add_status_index.py
from django.db import migrations, models


class Migration(migrations.Migration):

    dependencies = [
        ("orders", "0003_order_customer"),
    ]

    operations = [
        migrations.AddIndex(
            model_name="order",
            index=models.Index(fields=["status"], name="order_status_idx"),
        ),
    ]
جالبه که از جنگو ۲.۲ به بعد، روش پیشنهادی خودشون این شده که بهجای db_index=True روی خود فیلد، Index رو توی Meta تعریف کنی و دلیلش اینه که اینجوری کنترل بیشتری روی اسم Index و ترکیب فیلدها داری، و بعداً اگه خواستی چندتا فیلد رو با هم بذاری زیر یه Index، مسیرش هموارتره:
class Order(models.Model):
    status = models.CharField(max_length=20, choices=STATUS_CHOICES)
    created_at = models.DateTimeField(auto_now_add=True)
    customer = models.ForeignKey("Customer", on_delete=models.CASCADE)

    class Meta:
        indexes = [
            models.Index(fields=["status"], name="order_status_idx"),
        ]
بعد از تغییر مدل، دستور همیشگی رو میزنی:
python manage.py makemigrations orders
python manage.py migrate
روی جدولهای کوچیک این Migration در حد چند میلیثانیه اجرا میشه و اصلاً حسش نمیکنی اما روی جدولی که چند میلیون رکورد داره، ساخت Index میتونه چند دقیقه طول بکشه و در همون حین جدول رو قفل کنه که برای یه سرویس زنده اصلاً خبر خوبی نیست برای همین جنگو از نسخه ۳.۰ به بعد یه گزینه به اسم AddIndexConcurrently هم داره که با پستگرس هماهنگه و بدون قفل کردن کامل جدول این کار رو انجام میده فقط باید Migration رو Atomic نکنی و از بکند Postgres استفاده کنی
وقتی فیلتر روی چند فیلد همزمانه
تا اینجا فرض بر این بود که فقط یه فیلد رو فیلتر میکنی، ولی خیلی وقتها اینطوری نیست مثلاً یه فروشگاه داری و میخوای سفارشهای یه کاربر خاص رو که وضعیتشون «pending» هست پیدا کنی، یعنی Order.objects.filter(user=user, status='pending') اینجا یه Index تنها روی user یا تنها روی status کمک نصفهنیمه میکنه، چون Postgres باز مجبوره روی نتیجهی فیلتر اول، دستی بگرده دنبال فیلتر دوم
جوابش Composite Index هست، یعنی یه Index که چند ستون رو با هم میبینه نه جدا جدا که در جنگو تعریفش تو Meta.indexes انجام میشه:
class Order(models.Model):
    user = models.ForeignKey(User, on_delete=models.CASCADE)
    status = models.CharField(max_length=20)
    created_at = models.DateTimeField(auto_now_add=True)

    class Meta:
        indexes = [
            models.Index(fields=['user', 'status']),
        ]
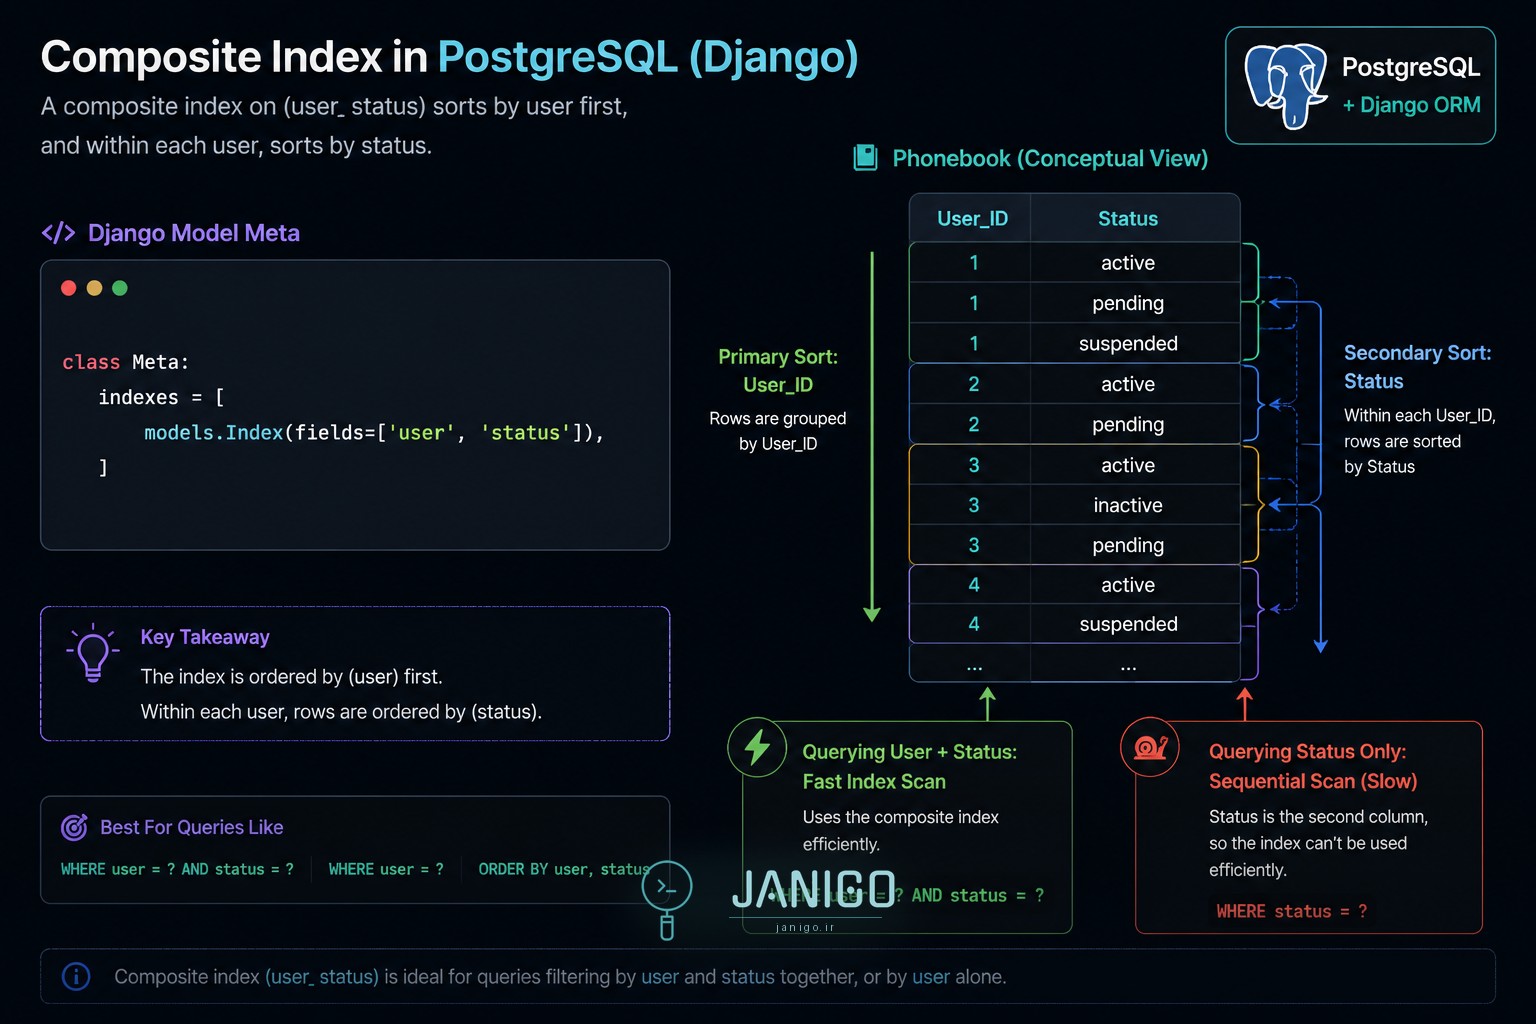
نکتهای که خیلیها ازش رد میشن ترتیب فیلدهاست، چون composite index مثل یه دفترچه تلفنیه که اول بر اساس فامیل مرتب شده و بعد بر اساس اسم و اگه فقط دنبال فامیل بگردی سریع پیدا میکنی، ولی اگه فقط دنبال اسم بگردی (بدون فامیل) باید کل دفترچه رو ورق بزنی یعنی Index روی ['user', 'status'] برای کوئریهایی که هر دو فیلد رو دارن یا فقط user رو دارن عالی کار میکنه، ولی برای کوئریای که فقط status رو فیلتر میکنه تقریباً بیفایدهست
پس قبل از نوشتن fields=[...] باید ببینی کوئری واقعی پروژهت چه شکلیه. اگه بیشتر جاها هر دو فیلد با هم میان، ترتیب رو بر اساس اینکه کدوم فیلد selectivity بیشتری داره بچین؛ یعنی فیلدی که مقادیرش متنوعتره (مثل user_id) رو معمولاً اول بگذار، نه فیلدی که فقط چند تا مقدار ثابت داره مثل status
یه اشتباه رایج اینه که برای هر ترکیب فیلتر یه composite index جدا میسازن، در حالی که اگه ترتیب فیلدها رو درست انتخاب کنی یه Index میتونه چند حالت رو کاور کنه
در پروژههای مشابه معمولاً کافیه لاگ کوئریهای پرتکرار رو نگاه کنی و ببینی کدوم دو سه فیلد همیشه با هم فیلتر میشن، همونها کاندید composite index هستن، نه هر ترکیب فرضی که به ذهنت میرسه
اشتباهاتی که Index رو بیفایده یا مضر میکنه
یه تصور اشتباه رایج هست که Index همیشه خوبه و هرچی بیشتر بزنی بهتره من هم یه زمانی همین فکر رو میکردم، تا اینکه روی یه جدول Order که مدام روش insert و update میشد، بعد از اضافه کردن پنج شش Index مختلف، سرعت درج رکورد جدید افت وحشتناکی کرد چون هر Index یعنی یه ساختار داده جدا که Postgres باید هر بار insert یا update موازی باهاش سینک نگه داره، پس هزینهش رایگان نیست
مشکل دوم اینه که خیلی وقتا Index رو روی فیلدی میزنیم که در عمل کم فیلتر میشه. فرض کن یه فیلد boolean داری مثل is_deleted که نودرصد رکوردها False هستن؛ Index روی این فیلد عملاً به Postgres کمک نمیکنه چون Selectivity پایینه و planner ترجیح میده همون Sequential Scan رو بزنه و جالبه که در این حالت حتی اگه Index رو دستی هم بزنی، خود Postgres ممکنه نادیدهش بگیره و بازم برای دلیل واقعی کندی باید جای دیگهای رو نگاه کنی
اشتباه سوم که خیلی گرون تموم میشه، فراموش کردن اجرای migration در پروداکشنه ! در پروژههای مشابه معمولاً یه نفر Index رو لوکال اضافه میکنه، تست میکنه، همه چی خوبه، ولی migration رو یا فراموش میکنه دیپلوی کنه یا روی یه جدول بزرگ اجرا میکنه بدون CONCURRENTLY و کل جدول برای چند دقیقه lock میشه که نتیجهش یا کوئری کند تو پروداکشن باقی میمونه بدون اینکه بفهمی چرا، یا بدتر، کل سایت برای چند دقیقه در حین اجرای migration از دسترس خارج میشه
آخرش قضیه اینجاست که Index یه ابزار دقیق برای یه مشکل مشخصه، نه یه اسپری همهکاره که هرجا شک کردی بزنیش و قبل از اضافه کردن هر Index جدید، از خودت بپرس این فیلد واقعاً چقدر توی WHERE و ORDER BY استفاده میشه، و آیا هزینهی نگهداریش روی نوشتنهای مکرر جدول ارزششو داره یا نه
چکلیست قبل از اضافه کردن Index
قبل از اینکه دستت بره سمت db_index=True یا یه Migration جدید بسازی، چند تا سوال از خودت بپرس
این چکلیست همون چیزیه که من قبل از هر Index جدید توی سرم مرور میکنم، و راستش بیشتر وقتا همینجا میفهمم که مسئله اصلاً Index نبوده
اول از همه EXPLAIN ANALYZE رو نگاه کن، نه حدس. اگه Postgres خودش داره Seq Scan میزنه روی جدولی با چهارصد ردیف، مشکل از Index نیست، مشکل از این دیدگاهه که فکر میکنی هر جدول کوچیک هم باید بهینه بشه. Index برای جدولای بزرگ معنی داره، برای جدولای کوچیک Postgres عاقلانهتر از این عمل میکنه که بخواد از Index استفاده کنه
بعدش فیلدهایی که واقعاً توی WHERE و ORDER BY و JOIN استفاده میشن رو لیست کن، نه هر فیلدی که به نظرت مهم میاد. من یه بار Index زدم روی فیلدی که فقط توی فرم ادمین نمایش داده میشد و هیچوقت توی Query فیلتر نمیشد؛ کاملاً بیفایده بود و فقط حجم دیتابیس رو بالا برد
بعد از این دو تا، به حجم نوشتن روی جدول فکر کن. اگه جدول مدنظرت هر ثانیه چند بار INSERT یا UPDATE میخوره، هر Index اضافه یعنی هزینه بیشتر روی همون نوشتنها. باید ببینی این هزینه با سرعتی که توی خوندن به دست میاری، واقعاً میارزه یا نه
نکته بعدی، ترتیب فیلدها توی Composite Indexه اگه چند فیلد رو با هم فیلتر میکنی، ترتیبشون توی Index باید با الگوی واقعی Queryهات هماهنگ باشه، وگرنه همون Index رو داری ولی استفاده نمیشه
در آخر، حتماً بعد از اضافه کردن Index دوباره EXPLAIN بگیر و مطمئن شو Planner واقعاً از Index جدید استفاده میکنه. بعضی وقتا Postgres به هر دلیلی، مثلاً کم بودن حجم داده یا آماری که هنوز آپدیت نشده، ترجیح میده همون Seq Scan رو بزنه؛ اونجاست که باید بری سمت ANALYZE دستی روی جدول
آخرش فقط یه قانون کلی هست که همیشه جواب میده: قبل از اضافه کردن هر Index، اول ثابت کن که بدون اون Index واقعاً مشکلی وجود داره
قبل از اینکه برای Performance پول خرج کنی، برای پیدا کردن دلیلش وقت خرج کن خیلی وقتا جواب فقط یه خط migration بوده
ارسال دیدگاه