


manage.py runserver فقط برای دولوپه نه پروداکشن !
شاید با خوندن تیتر بگی نهههه بابا راست میگی ؟ خیلی ضایع ست خب معلومه که برای پروداکشن این اصلا جواب نمیده
ولی خب باید بگم تو سطحت بالاس که اینو میگی برو یه مقاله دیگه رو بخون 😂
واقعا دیدم که میگم بعضی تازه وارد ها رو دیدم که فکر میکنن ران کردن یه پروژه جنگو مثل بالا اوردن یه ربات تلگرامی یا هر سرویس انلاین دیگه به صورت ساده است
بیان اسکریپت رو همونطوری که توی سیستمشون ران میکنن توی سرور ران کنن و نتیجه بگیرن
این متنم برای اوناست
باید بگم عملاً یه سناریوی فاجعهبار رو اجرا میکنی اگه داری این کارو میکنی چرا ؟ چون این runserver طراحی شده تا فقط توی محیط لوکال باشه
دستور runserver در واقع یه HTTP Server سبکِ تکمنظوره (Built-in) داخل خود پایتونه که میاد روی یه پورت (پیشفرض 8000) گوش وایمیسته (Listen میکنه)، درخواستهای خام HTTP رو از مرورگر میگیره، اونها را تبدیل به شیءِ قابل فهم برای جنگو (WSGIRequest) میکنه، میده به WSGI Handler / Request Pipeline جنگو، و در نهایت پاسخ رو برمیگردونه به مرورگر
این یعنی وقتی ران سرور میکنی اینطوری نیست که فکر کنی خب من اینو اجرا میکنم تا سایت رو ببینم پس این متود داره سایت و فقط راه میندازه
نه اصلا این متود کارش اینه که request ها رو هندل کنه و برای محیط توسعه ساخته شده یعنی برای request های خیلی محدود و اصلا مناسب پروداکشن نیست
و اگر ترافیک واقعی داشته باشه سایتت این سرویس اصلا از پس هندل کردن request ها برنمیاد
مشکل اصلی اینه که این سرور اصلاً برای بار و شرایط واقعی پروداکشن طراحی نشده و حتی اگه با پارامتر --bind کاری کنی که از بیرون هم قابل دسترسی باشه، باز هم قرار نیست امکانات و معماری لازم برای یه سرویس Production رو داشته باشه. شاید باز پیش خودت فکر کنی خب با افزایش RAM سرور مشکلو حل میکنی، ولی مسئله فقط RAM نیست؛ وقتی تعداد درخواستها بالا بره یا یه درخواست سنگین وارد سیستم بشه، این development server قرار نیست مثل یه سرویس واقعی Production زیر بار پایدار بمونه
از این گذشته، یه تفکر اشتباه رایج هست که فکر میکنن پروداکشن یعنی همین که بزنی DEBUG = False و پروژه رو بالا بیاری. غافل از اینکه وقتی DEBUG=False میشه، دیگه نباید روی رفتار Development Server برای سرو کردن فایلهای استاتیک حساب کنی و باید Static و Media رو به یه سرویس مناسب مثل Nginx یا Object Storage بسپری. تازه اونجاست که میفهمی Production فقط خاموش کردن Debug نیست؛ باید وبسرور، اپلیکیشن سرور، Static، Media، امنیت و مدیریت پردازشها هم درست کنار هم قرار بگیرن
Gunicorn چیه و چرا Web Server واقعی بهش نیاز داریم
توی محیط دِولوپمنت، runserver یه Development Server سبک و سادهست که برای راحتی توی زمان کدنویسی طراحی شده و اصلاً نباید تو فکر استفاده ازش برای Production باشی. حتی اگه بتونه چند درخواست همزمان رو با Thread مدیریت کنه، این به معنی Production-ready بودنش نیست و برای بار واقعی، امنیت و پایداری سرویس طراحی نشده
ما اینجا وارد دنیای Gunicorn میشیم که یه سرور WSGI واقعی و همزمانه و با مدیریت چندین وورکر (Worker Process) آمادهی بارهای ترافیک واقعی میشه
هر Worker یه پروسهٔ جداگانه پایتون هست که میتونه بهصورت موازی با Workerهای دیگه درخواستها رو پردازش کنه. این یعنی Gunicorn به جای اینکه کل Application رو به یه پردازش واحد محدود کنه، میتونه چند Process مستقل داشته باشه که هرکدوم درخواستهای خودشون رو هندل میکنن
مشکل اینجاست که وقتی فقط یه پروسه داری، هر درخواستی که بیاد باید صبر کنه تا درخواست قبلی تموم بشه و اگر اون یکی درخواست هم یه کندی داشته باشه، دومینو وار کل سایت قطع میشه
# شروع Gunicorn با تنظیمات ساده اما استاندارد
# تعداد Workerها باید با توجه به CPU، RAM و نوع بار برنامه تنظیم شود
gunicorn myproject.wsgi:application \
    --workers 3 \
    --bind 0.0.0.0:8000 \
    --timeout 120
این کانفیگ ساده یعنی ما ۳ تا Worker Process داریم که میتونن بهصورت موازی درخواستها رو پردازش کنن. بنابراین اگه یکی از Workerها درگیر یه درخواست سنگین یا کند بشه، Workerهای دیگه همچنان میتونن درخواستهای خودشون رو پردازش کنن
یکی از فرمولهای قدیمی و معروف برای تخمین اولیه تعداد Workerها اینه: (2 × CPU_CORES) + 1، ولی حواست باشه این فقط یه نقطه شروعه و قانون قطعی نیست. تعداد واقعی Workerها باید با توجه به CPU، RAM، نوع Worker، رفتار درخواستها و فشار روی دیتابیس انتخاب بشه
یعنی مثلا اگر سرورت ۲ هسته CPU داشته باشد:
(۲×۲)+۱=۵
ولی این به این معنی نیست که چون سرورت ۲ هسته داره حتماً باید ۵ تا Worker اجرا کنی؛ این فقط یه تخمین اولیهست و باید با مانیتورینگ واقعی سرور بررسی بشه
استفاده از bind 0.0.0.0:8000 یعنی Gunicorn آمادهی گوش دادن به تمام آدرسهای IP سروره و Nginx میتونه از بیرون بهش وصل بشه
تنظیمات حیاتی Gunicorn که اکثرها نادیده میگیرن
الان شاید تو هم فکر کنی gunicorn و فقط نصبش میکنی و دستور gunicorn myproject wsgi رو میزنی و انتظار داری همه چی خود به خود برای پروداکشن آماده بشه
ولی این فقط یه سرور WSGI هست و قرار نیست بدون تنظیمات مناسب تعداد پردازش ها مصرف رم فشار روی CPU و زمان پاسخگویی رو خودش مدیریت کنه
وقتی ترافیک واقعی وارد میشه تازه اهمیت تنظیماتش مشخص میشه هر Worker معمولا یه پردازش جداست و یه مقدار مشخصی از رم رو مصرف میکنه اگه تعداد Worker ها رو بدون توجه به رم و CPU زیاد کنی ممکنه رم سرور تموم بشه سیستم بره سراغ Swap و کل عملکرد سرور افت کنه
از اون طرف تعداد زیاد Worker باعث میشه CPU بیشتر درگیر جابه جایی بین پردازش ها بشه یعنی به جای اینکه درخواست ها رو درست پردازش کنه مدام بین Worker های مختلف جابه جا بشه
همونطور که گفتم یکی از فرمول های معروف برای تخمین اولیه تعداد Worker ها اینه
دو ضربدر تعداد هسته های CPU به علاوه یک
ولی این فرمول قانون قطعی نیست و برای همه پروژه ها جواب یکسانی نمیده مخصوصا توی پروژه هایی مثل Django که بیشتر زمان درخواست ها صرف انتظار برای دیتابیس یا سرویس های دیگه میشه
پس بهتره به جای اینکه کورکورانه طبق فرمول جلو بری اول با دو یا سه یا چهار Worker شروع کنی و مصرف رم CPU زمان پاسخگویی و فشار روی دیتابیس رو بررسی کنی
یه نکته مهم اینه که زیاد کردن Worker همیشه باعث سریع تر شدن برنامه نمیشه اگه تعدادشون بیشتر از ظرفیت سرور باشه ممکنه رم تموم بشه دیتابیس زیر فشار بره و زمان پاسخگویی حتی بیشتر هم بشه
تنظیماتی مثل keepalive و timeout هم باید با توجه به نوع پروژه و رفتار درخواست ها تنظیم بشن
البته برای اینکه یه درخواست سنگین دیتابیس بقیه درخواستها رو معطل نکنه، باید خود Queryها، Indexهای دیتابیس، Connection Pool، Cache و عملیات سنگین داخل Request رو بررسی کنی. برای کارهای واقعاً سنگین و طولانی هم بهتره به جای نگه داشتن Request، از Task Queue و Workerهای جداگانه استفاده کنی
در نهایت gunicorn فقط یه ابزار برای اجرای برنامه جنگو در محیط پروداکشنه و قرار نیست جای بهینه سازی کد دیتابیس و تنظیمات سرور رو بگیره تعداد Worker ها باید با توجه به منابع واقعی سرور انتخاب بشه و بعد با مانیتورینگ تنظیم بشه وگرنه چیزی که قرار بوده سرعت رو بیشتر کنه خودش باعث کندی و کرش سرور میشه
کافیه یه نگاهی به کد تنظیمات پایین بندازی تا ببینی چطور میشه عمر Workerها، زمان انتظار Requestها و مصرف منابع رو کنترل کرد تا یه درخواست سنگین یا یه مشکل تدریجی در مصرف حافظه نتونه کل سرویس رو تحت تأثیر قرار بده
# gunicorn.conf.py
# تنظیمات پایه
# تعداد Workerها باید با توجه به CPU، RAM و نوع بار برنامه تنظیم شود
# برای شروع میتوان با تعداد کمی Worker کار را شروع کرد و با مانیتورینگ تنظیمش کرد
workers = 3
worker_class = "sync" # برای پروژههای معمولی Django، sync کافیه
# حداکثر زمانی که Worker در زمان Shutdown یا Restart فرصت دارد
# تا Requestهای در حال اجرا را به شکل Graceful تمام کند
graceful_timeout = 30
timeout = 120
max_requests = 1000
max_requests_jitter = 50
# لاگینگ
accesslog = "-"
errorlog = "-"
loglevel = "warning"
توجهت رو میخوام به دو تا پارامتر max_requests و max_requests_jitter جلب کنم که به ظاهر سادهان ولی نجاتبخش هستن این دو پارامتر زمانی خیلی به درد میخورن که مصرف حافظه Workerها به مرور زمان افزایش پیدا کنه. max_requests باعث میشه Worker بعد از پردازش تعداد مشخصی Request بهصورت کنترلشده دوباره ساخته بشه و max_requests_jitter هم باعث میشه همه Workerها دقیقاً در یک لحظه Restart نشن. این کار میتونه اثر بعضی Memory Leakها یا افزایش تدریجی مصرف حافظه رو محدود کنه، ولی قرار نیست جای پیدا کردن و برطرف کردن خود Memory Leak رو بگیره
جیتتر یا همون نوسان تصادفی هم خیلی مهمن چون اگه همه Workerها دقیقاً همزمان Restart بشن، ممکنه برای یه بازه کوتاه ظرفیت پردازش درخواستها کم بشه و بسته به شرایط ارتباط Nginx و Gunicorn، کاربر با خطاهایی مثل 502 یا Timeout مواجه بشه. max_requests_jitter کمک میکنه Restart شدن Workerها از حالت همزمان خارج بشه
Nginx چطور به عنوان Reverse Proxy نجاتبخش عمل میکنه
فرض کن میخوای یه کافه راه بندازی که هم قهوه سرو کنه و هم آشغالها رو جمع کنه، هم برق رو مدیریت کنه و هم با مشتری چت کنه؛ کار تموم میشه چون نیروی متخصص (Django) درگیر جزئیات غیرمرتبط میشه. Nginx دقیقاً همون پیشخدمت حرفهاییه که بیرون میمونه، سفارش رو میگیره، عکس غذاها (Static Files) رو با کیفیت نشون میده و فقط وقتی واقعاً لازمه، درخواست رو به آشپزخونه (Gunicorn) میفرسته
بدون این لایه میانی، Gunicorn باید مستقیماً با Connectionهای Client و بخشی از کارهایی که معمولاً به وبسرور سپرده میشن درگیر باشه. Nginx میاد جلوی Gunicorn قرار میگیره و کارهایی مثل مدیریت Connectionهای Client، TLS، سرو فایلهای Static، محدودیت درخواستها و Reverse Proxy رو انجام میده تا Gunicorn بیشتر تمرکزش رو بذاره روی اجرای خود Application
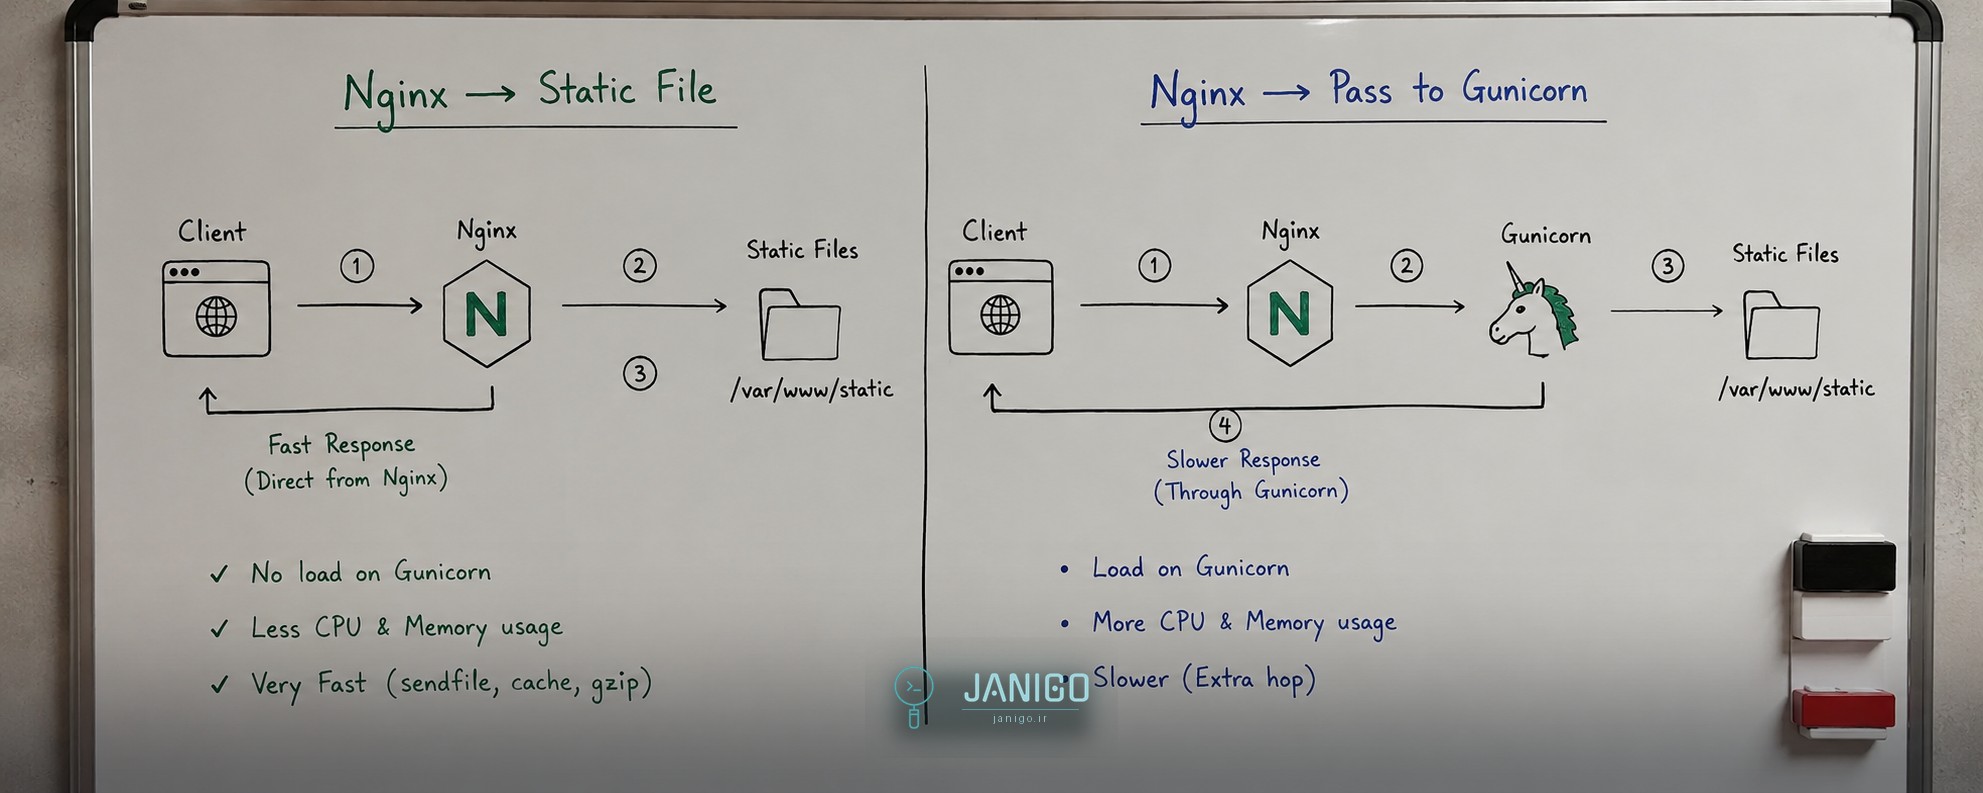
معماری استاندارد پروداکشن مثل یه تقسیم کار درسته کلاینت اول به انجینکس وصل میشه که به عنوان وب سرور و ریورس پراکسی جلوی در وایساده
اگه درخواست فایل استاتیک مثل عکس و فایل های سی اس اس و جاوااسکریپت باشه انجینکس خودش مستقیم و با بیشترین سرعت از روی دیسک تحویل میده و اصلا پای پایتون رو وسط نمیکشه
اما اگه درخواست داینامیک باشه اون رو پاس میده به gunicorn تا کد پایتون و منطق جنگو اجرا بشه
این تفکیک وظایف باعث میشه فشار بیخود از روی Django برداشته بشه، مدیریت Connectionها و TLS تا حد زیادی بیفته گردن Nginx و Gunicorn بیشتر روی اجرای منطق Application تمرکز کنه
کانفیگ Nginx: از Proxy Pass تا Static Files
اگر Nginx رو درست کانفیگ نکنی، عملاً داری Gunicorn رو مجبور میکنی کار بیهوده انجام بده و CPU سرورت پر میشه و جالبه که خیلیها فکر میکنن فقط کافیه ترافیک رو به Gunicorn بفرستند و تمام اما جدیت کار زمانی معلوم میشه که یه آپلود تصویر ۵ مگابایتی داشته باشی...
بیایم یه کانفیگ پایه و تمیز رو با هم مرور کنیم که ساختار کلی Nginx و Gunicorn رو نشون بده این مثال برای فهم معماریه و برای Production واقعی باید تنظیمات HTTPS، SSL و Security رو هم متناسب با سرورت بهش اضافه کنی در این مثال فرض میکنیم پروژهت در مسیر /opt/myproject قرار داره و فایلهای استاتیک و مِدیا رو هم جمعآوری کردی و این ساختار هم مدیریت فایلها رو ساده میکنه و هم فشار رو از روی دوش Gunicorn برمیداره
server {
listen 80;
server_name janigo.ir www.janigo.ir;
# مسیری که فایلهای استاتیک (CSS, JS, images) در اون جمع شدن
location /static/ {
alias /opt/myproject/static/;
# کشینگ طولانی برای اینکه مرورگر کاربر دوباره درخواست نده
expires 30d;
add_header Cache-Control "public, immutable";
}
# مسیری که فایلهای آپلودی کاربر (مثل عکس پروفایل) در اون هست
location /media/ {
alias /opt/myproject/media/;
# کشینگ کمتر برای محتوای پویا
expires 1d;
}
# بقیه درخواستها (HTML, API) میرن سمت گونیکورن
location / {
proxy_pass http://127.0.0.1:8000;
proxy_set_header Host $host;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
}
}
البته این کانفیگ فقط یه نمونه پایهست و برای Production واقعی باید HTTPS رو هم در نظر بگیری. معمولاً Nginx روی پورت 443 درخواستهای HTTPS رو دریافت میکنه، TLS رو Terminate میکنه و بعد Request رو به Gunicorn منتقل میکنه. برای گرفتن SSL هم میتونی از Let's Encrypt و ابزارهایی مثل Certbot استفاده کنی. اینکه سایتت با HTTPS بالا بیاد دیگه یه آپشن تزئینی نیست، مخصوصاً وقتی Login، Session یا اطلاعات حساس داری
Cache طولانی و immutable زمانی انتخاب خوبیه که اسم فایلهای Static با Version یا Hash تغییر کنه. مثلاً اگر فایل app.css رو هر بار با همون اسم تغییر بدی، ممکنه کاربر نسخه قدیمی رو از Cache ببینه؛ ولی اگر اسم فایل چیزی مثل app.8f31a.css باشه، با هر تغییر اسم فایل هم تغییر میکنه و Cache طولانی دیگه مشکلی ایجاد نمیکنه
نکتهٔ ظریف اینجا نحوه استفاده از alias هست. وقتی از alias استفاده میکنی، باید مسیر فایلها رو دقیق مشخص کنی و برای این نوع Location بهتره مسیر alias با / تموم بشه. تفاوتش با root هم اینه که root مسیر درخواست رو به مسیر فیزیکی اضافه میکنه، ولی alias خود Location رو با مسیر مشخصشده جایگزین میکنه؛ بنابراین اگر این دو رو اشتباه استفاده کنی خیلی راحت به 404 میرسی
در بخش location / هم ما داریم از proxy_pass برای فرستادن درخواست به gunicorn استفاده میکنیم. اما صرفاً گفتن http://127.0.0.1:8000 کافی نیست و باید هدرهای مهم رو هم بفرستی تا اپلیکیشن بتونه IP واقعی کاربر و پروتکل (HTTP/HTTPS) رو تشخیص بده. این Headerها هرکدوم یه وظیفه مشخص دارن. Host به Django کمک میکنه Host اصلی درخواست رو بشناسه، X-Real-IP و X-Forwarded-For برای منتقل کردن IP واقعی Client استفاده میشن و X-Forwarded-Proto هم مشخص میکنه Request اولیه با HTTP بوده یا HTTPS. مخصوصاً اگر پشت Reverse Proxy باشی، این اطلاعات برای لاگینگ، تشخیص IP و تنظیمات امنیتی و HTTPS مهمن
آخرش فقط یه بار با دستور sudo nginx -t تنظیمات رو چک کن و اگر اروری نگرفتی با sudo systemctl reload nginx تنظیمات جدید رو لود کن
این کار کمتر از یک ثانیه وقت میگیره ولی میتونه جلوی یه دردسر بزرگ رو بگیره و نجاتت بده از ساعت ها سرچ توی استک اورفلو و دیباگ کردن یه اشتباه کوچیک توی کانفیگ
چکلیست نهایی: قبل از اینکه لینک رو بفرستی چک کن
همهچیز نصب شده و لاگها اوکین اما قبل از اینکه لینک رو برای کلاینت یا دوستت بفرستی یه نفس عمیق بکش و این پنج تا مورد رو یکییکی استرسوار چک کن اشتباهات بچگانه مثل فراموشی User یا مجوزهای اشتباه فایلها، معمولاً آخر شب و بعد از پنج ساعت دیباگ، خودشون رو با خطای ۵۰۰ نشون میدن
اولین چیزی که باید چک کنی اینه که آیا Gunicorn واقعاً تحت یه User جداگانه و غیر root داره اجرا میشه یا نه. اجرا به عنوان root یک خودکشی امنیتی محضه و هیچ بهانهای مثل «سادهتره» برای این کار قانعکننده نیست، پس سریع برید سراغ ساختن یه User مخصوص مثل django_user در سیستمعامل و مطمئن بشید که فایلهای پروژه و دیتابیس قابل نوشتن و خوندن توسط اون هستند
بعد از اطمینان از مجوزها، تست کن ببین آیا فایلهای استاتیک (CSS/JS/Image) در محیط پروداکشن لود میشن یا نه. خیلی وقتها Nginx درست کانفیگ شده ولی STATIC_ROOT رو درست تنظیم نکردی یا collectstatic رو اجرا نکردی و در نتیجه کاربری که وارد سایت میشه یه صفحه خاکستری و خالی میبینه
یه نکته مهم دیگه که خیلیا نادیده میگیرن بررسی کردن لاگ های خطای انجینکس و خروجی خطای گانیکورنه
لاگ های موفقیت مثل access log فقط نشون میدن درخواست به سرور رسیده و چه status code ای برگشته ولی لزوما نمیگن داخل برنامه چه اتفاقی افتاده
اگه یه خطای داخلی رخ داده باشه یا gunicorn نتونه درخواست رو درست به جنگو برسونه باید سراغ error log انجینکس و stderr بری چون معمولا سرنخ اصلی مشکل همونجاست
پس قبل از اینکه لپ تاپت رو ببندی یه درخواست تست بفرست بعد لاگ ها رو بررسی کن تا مطمئن بشی هم انجینکس درخواست رو گرفته هم گانیکورن تونسته برنامه رو اجرا کنه و هم پاسخ درست به کاربر برگشته
این چک لیست ساده مرز بین اینه که فکر کنی سایتت درست کار میکنه یا اینکه در سکوت داره ارور میده پس وقتی همه چی رو تست کردی با خیال راحت پروژه رو تحویل بده یا لینکش رو بفرست
آخرش فقط کار میکنه، دیگه چی میخوای؟
کل ماجرا همین بود نه نیاز به کدنویسی عجیب غریبی داشتیم نه کار فضایی انجام دادیم فقط دو تا سرویس رو درست و اصولی به هم وصل کردیم
خیلی از دولوپرها دقیقا همینجا گیر میکنن چون فکر میکنن دپلوی یعنی کد زدن بیشتر در حالی که دپلوی یعنی معماری درست تقسیم وظایف و مدیریت منابع سرور
وقتی انجینکس جلوی ترافیک وایمیسته استاتیک ها رو پرسرعت تحویل میده اس اس ال رو مدیریت میکنه و gunicorn پشت صحنه میره سراغ اجرای منطق پایتون دیگه پروژه ات یه اسکریپت ساده روی سیستم لوکال نیست بلکه یه سرویس استاندارد و پایدار روی اینترنته
این معماری همون الگوی استاندارد و تست شده ایه که توی دنیای واقعی استفاده میشه و باعث میشه سرور الکی زیر بار ترافیک نخوابه
مرسی از وقتی که برای خوندن این مقاله گذاشتی
با نظرت خوشحالم کن ;)
ارسال دیدگاه